
الإجابة المباشرة: يمكنك الآن منع تدريب الذكاء الاصطناعي على موقعك بسطر مشترك جديد في robots.txt هو User-Agent: __usage_ai-training يليه Disallow: /. أعلنت Google وMicrosoft وOpenAI وAnthropic في 30 أكتوبر 2026 أنها ستحترمه كتفضيلك برفض تدريب نماذج الذكاء الاصطناعي التوليدي. لكن لا أحد يقرؤه بعد: Microsoft تبدأ في 1 فبراير 2027، وGoogle في مطلع 2027، وOpenAI «خلال الأشهر المقبلة»، وAnthropic بدأت التنفيذ. لا يغيّر السطر ترتيبك في Google أو Bing، لكنه لدى Google سيعمل كحظر لـ Google-Extended، وهذا يُخرج صفحاتك أيضًا من إجابات Gemini التي تستشهد بالمصادر. لذلك على مواقع الخليج ومصر أن تقرر مسارًا بمسار لا بسطر شامل واحد.
حقائق أساسية (تم التحقق في 1 نوفمبر 2026، 09:15 بتوقيت غزة)
- ما هو: رمز سياسة محايد في robots.txt اسمه
__usage_ai-training، معرَّف في المسودة الفردية draft-kelley-aipref-training-preference-signal-00 (كيفن كيلي من Anthropic، 30 أكتوبر 2026، تنتهي صلاحيتها 3 مايو 2027). - الوضع: ليس معيارًا رسميًا. تقول صفحة IETF إن المسودة «غير معتمدة من IETF وليس لها وضع رسمي» (IETF).
- من يدعمه: منشورات Google وMicrosoft Bing وOpenAI في 30 أكتوبر 2026، وAnthropic عبر رسالة كيلي (15:39 بالتوقيت العالمي، 17:39 بتوقيت غزة).
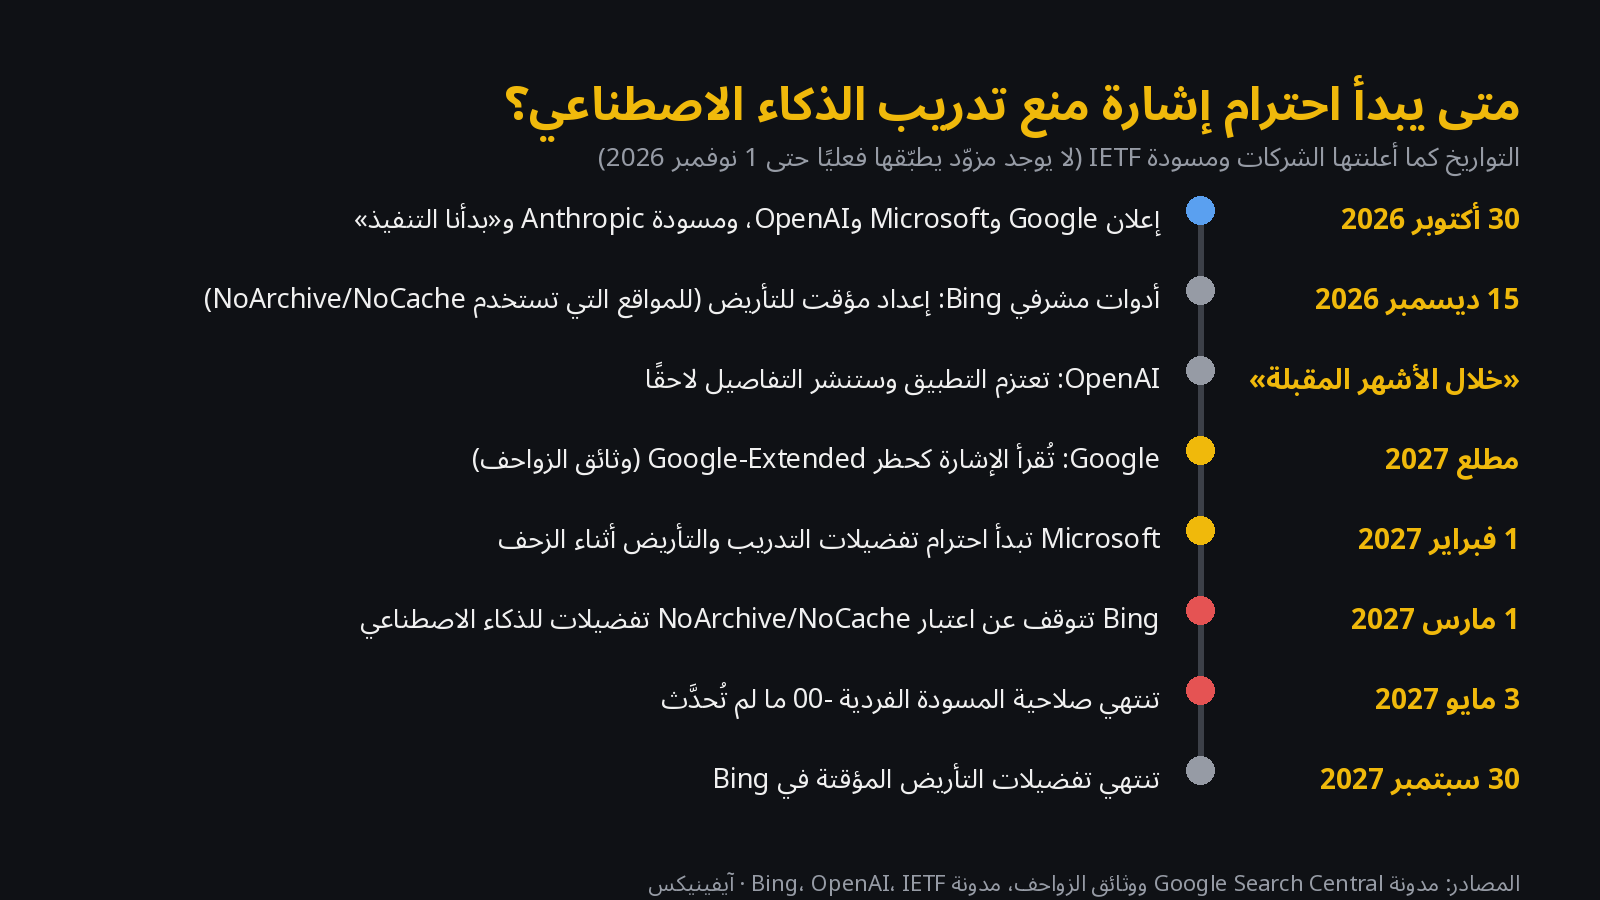
- المواعيد: Microsoft في 1 فبراير 2027؛ Google «مطلع 2027»؛ OpenAI «خلال الأشهر المقبلة»؛ Anthropic «بدأت التنفيذ» بلا موعد.
- النجمة لا تكفي: مجموعة
User-agent: *لا تطابق الرمز أبدًا، وغياب مجموعة الرمز يعني عدم التعبير عن أي تفضيل. - الترتيب: تؤكد Google وMicrosoft أن الظهور والترتيب في البحث لا يتأثران.
- تنبيه Google: المنع بالرمز دون سطر Google-Extended يُقرأ كحظر لـ Google-Extended، الذي يشمل الاستشهاد في Gemini Apps وVertex AI.
- إضافات Microsoft: إعدادات
ai-trainingوai-groundingعلى مستوى الصفحة، وتوقف اعتبار NoArchive وNoCache بعد 1 مارس 2027.
صار منع تدريب الذكاء الاصطناعي على موقعك ممكنًا بإشارة واحدة تفهمها الشركات الكبرى، منذ يوم الجمعة 30 أكتوبر 2026. نشرت Google وMicrosoft وOpenAI منشورات تقول إنها ستحترم سطرًا مشتركًا في robots.txt كتفضيل للموقع بشأن تدريب الذكاء الاصطناعي التوليدي. وفي اليوم نفسه قدّم كيفن كيلي، المهندس في Anthropic، مسودة IETF التي تعرّف هذا السطر، وكتب أن Anthropic «بدأت بالفعل تنفيذ الدعم». هذه أول مرة يستطيع فيها ناشر أخبار أو متجر إلكتروني أو شركة SaaS أو بوابة حكومية في الإمارات والسعودية ومصر مخاطبة كل صانعي النماذج الكبار بسطر واحد. ويطرح ذلك سؤالًا تجاهلته التغطية الإنجليزية: إذا كنت تنشر بالعربية، فهل تريد حقًا أن تختفي من إجابات الذكاء الاصطناعي؟
يشرح هذا الدليل ما يفعله الرمز وما لا يفعله، ومتى تبدأ كل شركة في قراءته. ويقدّم أمثلة جاهزة لووردبريس وNginx وCloudflare، وجدول قرار مصممًا لأنواع المواقع في الخليج ومصر. كل تاريخ واقتباس هنا مأخوذ من الإعلانات الأربعة الأصلية ومسودة IETF، وحين يكون الاستنتاج قراءتنا نحن لا تصريح الشركة نقول ذلك صراحة.
ما هي إشارة منع تدريب الذكاء الاصطناعي في robots.txt؟
ملف robots.txt ملف نصي في جذر كل موقع يخبر الزواحف بما يُسمح لها بجلبه، وقواعده موحّدة في RFC 9309. حتى الآن كان على من يريد قول «لا تدرّبوا الذكاء الاصطناعي على محتواي» أن يذكر زاحف كل شركة أو رمزها واحدًا واحدًا: GPTBot لـ OpenAI، وGoogle-Extended لـ Google، وClaudeBot لـ Anthropic، وهكذا.
المسودة الجديدة لا تغيّر قواعد robots.txt إطلاقًا. بدلًا من اسم زاحف يحمل سطر User-Agent رمز سياسة هو __usage_ai-training، وتقول القواعد تحته أين أنت ضد التدريب وأين أنت معه. هذا مثال المسودة نفسها:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
تعني هذه المجموعة رفض التدريب على كل المسارات ما عدا /press-kit/ الذي يُسمح بالتدريب عليه (مسودة IETF). ومطابقة المسارات كأي قاعدة robots.txt، والأطول تطابقًا يفوز. أما تعريف التدريب فمأخوذ من مسودة المفردات لمجموعة عمل AIPREF: «استخدام أصل لتعديل المعاملات المتعلَّمة لنموذج ذكاء اصطناعي توليدي». ويُستثنى تدريب النماذج غير التوليدية المستخدمة للتصنيف أو الترتيب أو التقييم فقط.
تفضيل للاستخدام وليس بوابة
تقول المسودة إن الرمز «ليس أمرًا لسلوك الزحف». تواصل الزواحف اتباع القواعد الخاصة بأسمائها، و*يجوز* لها ألا تجلب ما لا تستطيع استخدامه، لكن لا شيء في robots.txt يمنع الروبوت تقنيًا. إذا احتجت إلى منع فعلي فهذه مهمة جدار حماية أو أداة إدارة روبوتات.
أي الشركات ستحترم الإشارة ومتى؟
| المزوّد | ما قاله في 30 أكتوبر 2026 | الموعد | الضوابط الحالية |
|---|---|---|---|
| ستعامل المنع بالرمز «كأن الناشر حظر Google-Extended» ما لم يُذكر Google-Extended صراحة (المدونة) | «في 2027» (المدونة)؛ «مطلع 2027» (وثائق الزواحف) | Google-Extended يستمر | |
| Microsoft Bing | تعتمد تفضيل التدريب المشترك وتضيف إعدادات للتدريب والتأريض على مستوى الصفحة (Bing) | أثناء الزحف بدءًا من 1 فبراير 2027 | إلغاء NoArchive وNoCache كإشارات ذكاء اصطناعي بعد 1 مارس 2027 |
| OpenAI | ستحترم الإشارة المشتركة في robots.txt بشأن «التدريب التأسيسي للذكاء الاصطناعي التوليدي» (OpenAI) | «خلال الأشهر المقبلة»، والتفاصيل لاحقًا | قواعد GPTBot وOAI-SearchBot تبقى سارية |
| Anthropic | «بدأت بالفعل تنفيذ دعم هذه المسودة» (كيلي، قائمة IETF) | بلا موعد؛ «سيستغرق ذلك بعض الوقت» | تكمّل ضوابط الزواحف الحالية |
وهناك أمران لا يظهران في الجدول. الأول أن Apple وMeta وAmazon لم تعلن دعمها في 30 أكتوبر، فإن أردت مخاطبة زواحفها فما زلت تحتاج إلى قواعد خاصة بها. والثاني أن الإشارة طوعية: OpenAI تسمي مشاركتها «جهدًا طوعيًا»، والمسودة بلا أي آلية إلزام.
هل يؤثر منع تدريب الذكاء الاصطناعي على ترتيبي في Google وBing؟
لا. تقول وثائق Google إن Google-Extended «لا يؤثر على ظهور الموقع في بحث Google ولا يُستخدم كإشارة ترتيب» (Google). وتقول Microsoft إن التفضيلات الجديدة لا تغيّر أهلية الظهور في نتائج Bing (Bing). كما أن الرمز لا يغيّر طريقة زحف Googlebot أو Bingbot لأنهما يقرآن مجموعاتهما الخاصة. فإذا أمضيت سنوات في تحسين موقع عربي لمحركات البحث، فإضافة الرمز لن تحرّك ترتيبك في الروابط الزرقاء.
هل يُخرجني منع التدريب من إجابات Gemini وCopilot وChatGPT؟
هذا السؤال الأهم للظهور، والإجابة تختلف من شركة لأخرى. التدريب يغيّر ما *تعرفه* النماذج مستقبلًا. أما التأريض فيحدد الصفحات التي يقرؤها المساعد ويستشهد بها مع روابط حين يجيب عن سؤال *اليوم*. يسهل الخلط بينهما، والشركات تعاملهما بشكل مختلف.
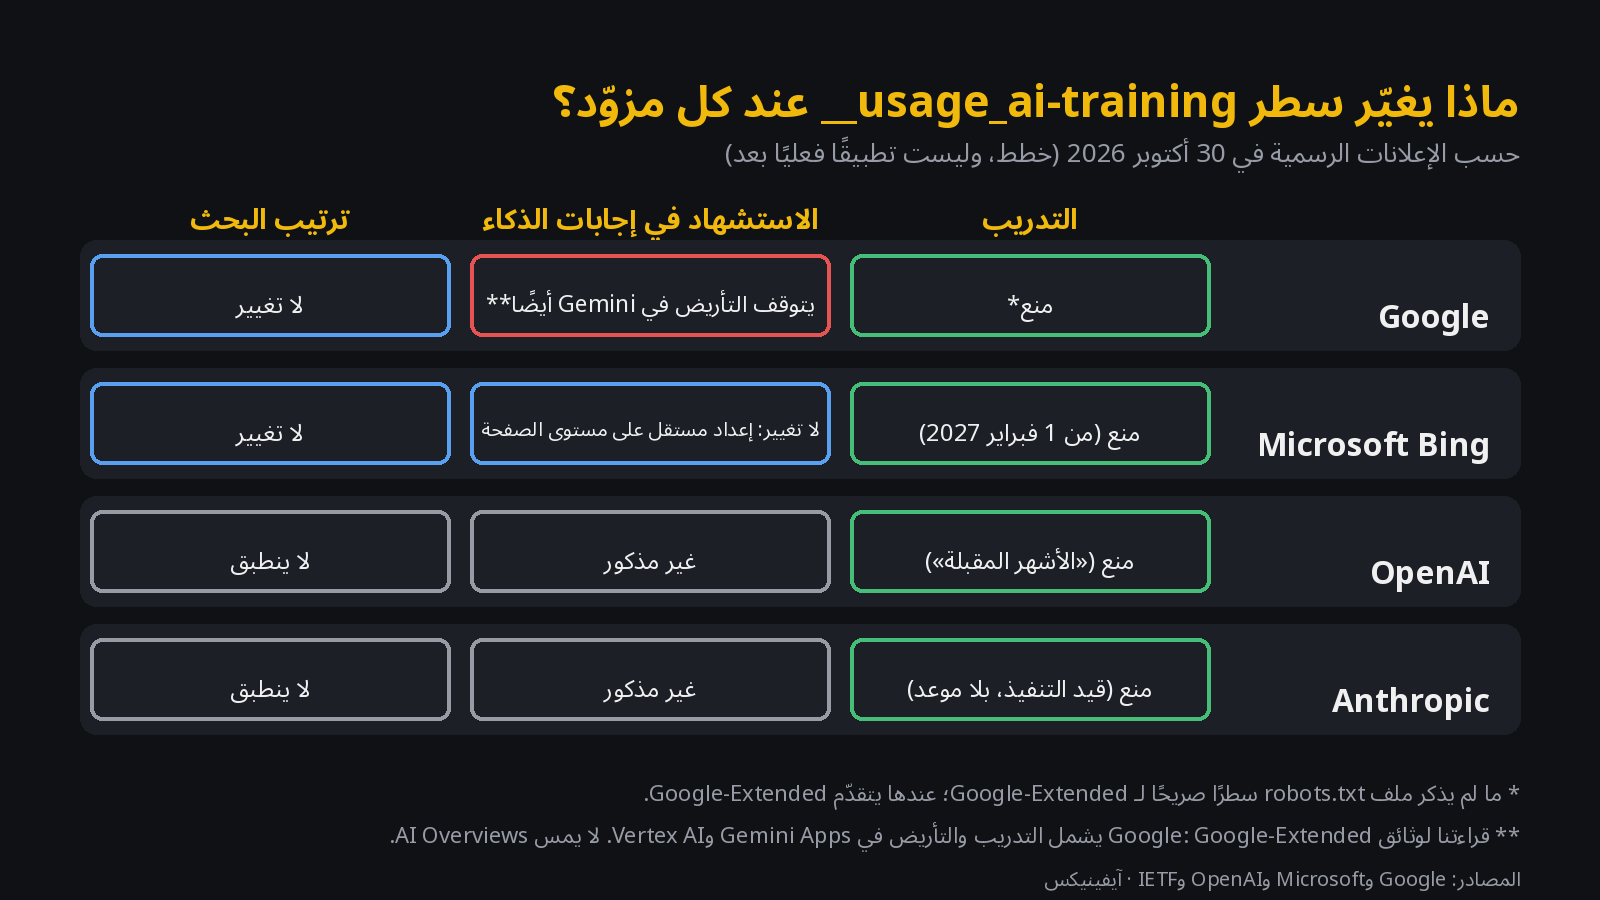
- Google: يشمل Google-Extended تدريب نماذج Gemini المستقبلية *و*التأريض، أي تزويد النموذج بمحتوى من فهرس بحث Google لحظة السؤال، في Gemini Apps وفي Grounding with Google Search على Vertex AI (الوثائق). لذلك فالمنع بالرمز دون سطر Google-Extended سيُخرج صفحاتك أيضًا من إجابات Gemini المستندة إلى المصادر، وهذه قراءتنا للوثيقتين معًا. وتقول مدونة Google الوجه الآخر: المواقع التي تسمح صراحةً بـ Google-Extended «مؤهلة للظهور في الإجابات والحصول على نقرات عبر التأريض في Gemini Apps». أما AI Overviews وAI Mode في بحث Google فتخضع لقواعد Googlebot لا لهذا الرمز.
- Microsoft: الرمز يخص التدريب فقط. أما التأريض في Bing وCopilot وMicrosoft 365 فله إعداد مستقل على مستوى الصفحة بثلاث قيم:
Allow(الافتراضي)، وDisallowExtended(منتجات Microsoft فقط دون خدمات التأريض المقدَّمة لأطراف ثالثة مثل Web IQ)، وDisallow(Bing). - OpenAI: ميزات البحث في ChatGPT تعتمد على OAI-SearchBot، وتوثّقه OpenAI كإعداد مستقل عن GPTBot زاحف التدريب (وثائق OpenAI). ولم تقل OpenAI بعد كيف سيرتبط الرمز المشترك بهما.
- Anthropic: يقول كيلي إن الرمز يكمّل ضوابط الزواحف الحالية، ولم تُنشر تفاصيل التنفيذ بعد.
«لا يضمن أيّ من الخيارين الظهور أو الزيارات أو الدفع».
Microsoft Bing، عن السماح بالتدريب والتأريض، 30 أكتوبر 2026 (ترجمة آيفينيكس)
ما الفرق بين Google-Extended وGPTBot وClaudeBot والرمز الجديد؟
| الاسم في robots.txt | النوع | من يقرؤه | ما يتحكم فيه |
|---|---|---|---|
__usage_ai-training | رمز سياسة مشترك (جديد) | Google وMicrosoft وOpenAI وAnthropic عند التفعيل | تفضيل تدريب الذكاء الاصطناعي التوليدي حسب المسار |
Google-Extended | رمز تحكم من Google (بلا زاحف مستقل) | تدريب Gemini والاستشهاد في Gemini Apps وVertex AI | |
GPTBot | زاحف OpenAI | OpenAI | المحتوى الذي قد يُستخدم لتدريب نماذج OpenAI |
OAI-SearchBot | زاحف OpenAI | OpenAI | الظهور في إجابات بحث ChatGPT |
ClaudeBot | زاحف Anthropic | Anthropic | المحتوى الذي قد يسهم في التدريب |
User-agent: * | النجمة | كل الزواحف | الوصول للزحف، وليس أبدًا تفضيلًا للتدريب وفق المسودة |
وسم Bingbot بقيمة ai-training أو ai-grounding | إعداد على مستوى الصفحة | Microsoft من 1 فبراير 2027 | تجاوز التدريب لكل صفحة، والتأريض لكل صفحة |
قاعدة الأولوية في المسودة قصيرة: «ينبغي أن تتقدّم التعبيرات الخاصة على العامة»، ويجوز للشركة اعتبار رمزها الخاص أكثر تحديدًا، وهذا بالضبط ما فعلته Google مع Google-Extended. وتقول المسودة أيضًا إن «الاتفاقات الخاصة يجوز أن تتجاوز التفضيلات»، فاتفاق الترخيص مع شركة ذكاء اصطناعي قد يتقدّم على الرمز.
لماذا لا يكفي سطر User-agent: * الموجود عندي؟
⚠️ خطأ شائع
إذا كان ملفك يقول User-agent: * وDisallow: / فقد منعت الزحف، ولم تعبّر عن تفضيل بشأن التدريب. المسودة صريحة: مجموعات النجمة «يجب ألا تُفسَّر على أنها تطابق رمز السياسة»، وإذا لم توجد مجموعة __usage_ai-training «فلم يُعبَّر عن أي تفضيل». يجب أن تكتب الرمز باسمه.
ويشرح كيلي هذا الاختيار التصميمي: أي ملف robots.txt لا يستخدم الآلية، وهذا حال كل الملفات المنشورة اليوم، «لا يعبّر عن أي تفضيل» (قائمة IETF). هذا يحمي ملايين الملفات القديمة من إعادة تفسيرها بطريقة لم يقصدها أصحابها، لكنه يعني أيضًا أن الإشارة الجديدة لا تقول شيئًا نيابة عنك حتى تضيف السطر. وموقع ifynx.com في الوضع نفسه: حتى صباح اليوم لا يحتوي ملفه على مجموعة __usage_ai-training، مثل معظم مواقع الويب تقريبًا.
المعادلة العربية: لماذا تملك مواقع الخليج ومصر ورقة قوة؟
تتعامل معظم التغطية الإنجليزية مع المنع كخيار بديهي للناشرين، لكن الحساب بالعربية مختلف. المحتوى العربي عالي الجودة على الويب المفتوح أقل بكثير من الإنجليزي، فأرشيف أخبار عربي محرَّر جيدًا، أو كتالوج منتجات ثنائي اللغة، أو دليل خدمات حكومية سعودي أو إماراتي، مورد نادر لصانعي النماذج. هذه الندرة تمنح أصحاب المحتوى العربي ورقة تفاوض، وهي أيضًا سبب اعتماد المساعدات الذكية كثيرًا على مصادر ضعيفة أو مترجمة حين تجيب بالعربية.
والندرة نفسها تعمل في الاتجاه المعاكس بالنسبة للظهور. إذا كانت صفحاتك العربية أفضل إجابة عن سؤال حول الفوترة الإلكترونية في السعودية أو خدمات التأشيرات في الإمارات أو قواعد الشحن في مصر، فإن قراءة Gemini أو Copilot أو ChatGPT لها والاستشهاد بها توزيع مجاني. ومنع التدريب لدى Google دون سماح صريح لـ Google-Extended يعني أيضًا الخروج من الاستشهاد في Gemini، وقد يكلّف ذلك متجرًا أو شركة SaaS تريد أن تُرشَّح أكثر مما يحميها.
قاعدتنا العملية
احمِ ما تبيعه، وأظهر ما يبيعك. الصحافة المدفوعة والأبحاث والدورات والبيانات الخاصة: امنع التدريب. صفحات المنتجات والوثائق والأسعار ومراكز المساعدة والمواد الصحفية: اتركها مقروءة، وقرّر الاستشهاد لكل مزوّد على حدة.
هل يمنع موقعي التدريب؟ جدول قرار لمواقع الخليج ومصر
| نوع الموقع | التدريب (__usage_ai-training) | Google-Extended | التأريض في Bing (للصفحة) | السبب |
|---|---|---|---|---|
| ناشر أخبار عربي/إنجليزي | منع /، والسماح بـ /press/ وصفحات من نحن والتواصل | بلا ذكر (محظور عبر الرمز) إلا إن كانت زيارات Gemini مهمة | DisallowExtended للمقالات المميزة | الأرشيف هو المنتج، ومفاوضات الترخيص تحتاج منعًا موثقًا |
| متجر إلكتروني (الإمارات، السعودية، مصر) | سماح، أو منع /blog/ والمراجعات فقط | سماح | سماح | إجابات التسوق الذكية تجلب اكتشاف المنتجات |
| وثائق SaaS والتقنية المالية | سماح لـ /docs/ ومنع المسارات الخاصة بالعملاء | سماح | سماح | المطورون يسألون المساعدات عن التكامل، والإجابة الخاطئة تكلّف الدعم |
| البوابات الحكومية وشبه الحكومية | حسب سياسة الجهة، وغالبًا سماح لأدلة الخدمات العامة | سماح للأدلة العامة | سماح | المواطن يسأل الذكاء الاصطناعي بالعربية، والإجابة الصحيحة تخفف الضغط على مراكز الاتصال |
| الجامعات ومواقع الأبحاث والدورات | منع المواد الدراسية والأبحاث، والسماح بصفحات القبول | حسب الحالة | DisallowExtended للدورات المدفوعة | المحتوى الدراسي هو الأصل، ومعلومات القبول يجب أن تُوجد |
| البنوك والجهات المنظَّمة | منع الأدوات والحاسبات، والسماح بإفصاحات المنتجات والرسوم | سماح للإفصاحات | سماح للإفصاحات | دقة إجابات الرسوم والمنتجات أهم من إخفائها |
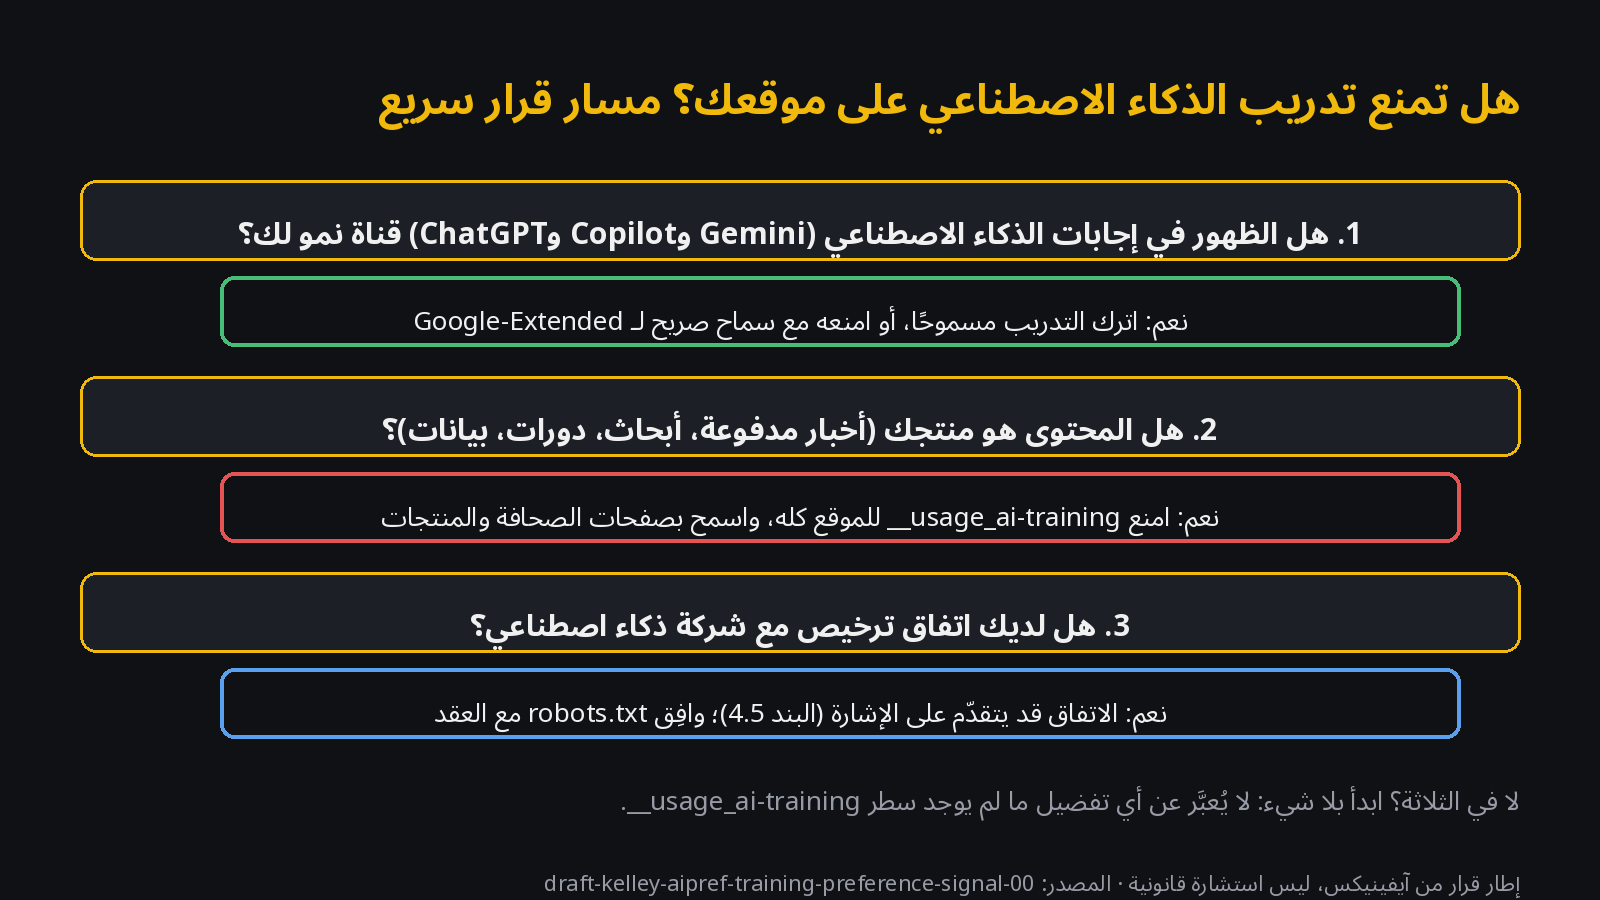
هذا الجدول ليس استشارة قانونية. تختلف قواعد حقوق النشر واستخدام البيانات بين الإمارات والسعودية ومصر، ولم نجد حتى 1 نوفمبر 2026 بيانًا من جهة تنظيمية في الدول الثلاث بشأن هذا الرمز. إن كان لدى مؤسستك فريق قانوني أو فريق حوكمة بيانات فاعرض القرار عليه.
أمثلة robots.txt جاهزة لووردبريس وNginx وCloudflare
1. منع تدريب الذكاء الاصطناعي على الموقع كله
# Opt out of generative AI training for the whole site
User-Agent: __usage_ai-training
Disallow: /

# Keep normal crawling and search rules as they are
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/wp-sitemap.xml
2. منع التدريب مع البقاء مؤهلًا لإجابات Gemini
لأن Google-Extended يشمل التدريب والاستشهاد معًا، لا تقدّم Google إعدادًا لعبارة «استشهد بي ولا تتدرّب عليّ». السماح الصريح لـ Google-Extended يُبقي الاستشهاد في Gemini، لكنه يسمح أيضًا بتدريب Gemini. اختر ذلك عن وعي.
# Opt out of training at providers that read the shared token...
User-Agent: __usage_ai-training
Disallow: /

# ...but stay eligible for Gemini grounding (note: this also
# allows Gemini training, because Google-Extended covers both)
User-agent: Google-Extended
Allow: /
3. على مستوى المسار: احمِ الأرشيف وأبقِ المنتجات والوثائق مفتوحة
# News archive and paid research: no training.
# Product pages, press kit and docs: training allowed.
User-Agent: __usage_ai-training
Disallow: /
Allow: /products/
Allow: /press/
Allow: /docs/
تتحدث مدونة Google عن حالة الموقع الكامل فقط، ولم توضح بعد كيف ستُترجم قواعد المسارات إلى قواعد Google-Extended، فراجع وثائق Google قبل الاعتماد على قواعد المسارات لديها.
ووردبريس
يقدّم ووردبريس ملف robots.txt افتراضيًا ما لم يوجد ملف حقيقي في جذر الموقع. أمامك ثلاثة خيارات: رفع ملف فعلي، أو محرر robots.txt في إضافة SEO، أو إضافة صغيرة من نوع must-use تضيف المجموعة إلى الملف الافتراضي:
<?php
// wp-content/mu-plugins/ai-training-pref.php
// Adds the shared AI training opt-out to WordPress's virtual robots.txt.
// Ignored if a physical robots.txt file exists in the web root.
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( ! $public ) { return $output; }
    return "User-Agent: __usage_ai-training\nDisallow: /\n\n" . $output;
}, 10, 2 );
Nginx (للخوادم متعددة المواقع)
# Serve a static robots.txt for every vhost you manage
location = /robots.txt {
    alias /etc/nginx/robots/robots.txt;
    default_type text/plain;
    add_header Cache-Control "public, max-age=3600";
}
Cloudflare
إذا فعّلت ملف robots.txt المُدار من Cloudflare (Bot Preference Sync) فستضيف Cloudflare كتلتها في أعلى ملفك، وتشمل Content Signals وقواعد لأسماء مثل Google-Extended وGPTBot (وثائق Cloudflare). ولا تذكر الوثائق، المحدَّثة في 22 أكتوبر 2026، رمز __usage_ai-training، فأضفه في ملف الخادم الأصلي وافحص الناتج المدمج. وانتبه: سطر Google-Extended: Disallow المُدار يُعد «ذكرًا صريحًا» لدى Google، فيتقدّم على ما تقوله مجموعة الرمز.
إعدادات Microsoft على مستوى الصفحة وموعد NoArchive وNoCache
Microsoft هي الوحيدة التي نشرت خطة انتقال كاملة. إن كنت تستخدم NoArchive أو NoCache اليوم لإبعاد صفحاتك عن Copilot، فلن يُعتد بهما كتفضيلات للذكاء الاصطناعي بعد 1 مارس 2027. وتقول Microsoft إنها حين تكتشف التفضيلات الجديدة على موقع «ستتجاهل أي تفضيلات NoArchive وNoCache متبقية». أي أن إضافة الرمز وحده قد تُسقط قيد التأريض لديك، لذا انشر إعداد التأريض على مستوى الصفحة معه:
<!-- Page level, Microsoft only (from 1 Feb 2027) -->
<meta name="Bingbot" content="ai-training:disallow">
<meta name="Bingbot" content="ai-grounding:disallowextended">

# Or as HTTP response headers
X-Robots-Tag: Bingbot: ai-training:disallow
X-Robots-Tag: Bingbot: ai-grounding:disallowextended- 15 ديسمبر 2026: فتح التفضيلات المؤقتة للتأريض في أدوات مشرفي Bing، فقط للمواقع التي تستخدم NoArchive أو NoCache في ذلك التاريخ.
- 1 فبراير 2027: تبدأ Microsoft احترام تفضيلات التدريب والتأريض أثناء الزحف.
- 1 مارس 2027: لا يُعتد بـ NoArchive وNoCache كتفضيلات للتدريب أو التأريض.
- 30 سبتمبر 2027: تنتهي أي تفضيلات مؤقتة متبقية.
كيف تختبر ملف robots.txt بعد التعديل؟
- اجلب الملف الحي بأمر curl لا من معاينة نظام إدارة المحتوى، وتأكد من الحالة
200ونوعtext/plainوظهور مجموعة__usage_ai-trainingمرة واحدة. - افحص الملف المدمج خلف شبكة التوزيع: قد تضيف Cloudflare أو غيرها قواعد مُدارة، فاقرأ الاستجابة كاملة.
- اكتب الرمز حرفيًا: شرطتان سفليتان ثم
usageثم شرطة سفلية ثمai-training. المطابقة لا تميّز حالة الأحرف، لكن الخطأ الإملائي يصبح اسم زاحف مجهولًا تتجاهله كل الزواحف. - افصل قواعد الزحف: لا تحذف قواعد Googlebot أو
User-agent: *. الرمز يضيف تفضيل استخدام ولا يستبدل قواعد الوصول. - ابحث عن التعارض: إذا وُجدت مجموعة صريحة لـ
Google-ExtendedأوGPTBotفهي التي تقرر لتلك الشركة. - راقب حجم الملف: يُلزم RFC 9309 المحللات بقراءة 500 كيبيبايت على الأقل، والرمز وُجد جزئيًا لتتوقف عن تكرار القوائم الطويلة.
- تحقق في Search Console وأدوات مشرفي Bing: قد تنبّه Search Console إلى أسطر جديدة لا تفهمها، وهذا وحده ليس خطأ.
- سجّل تاريخ التعديل: المسودة تربط التفضيل بملف robots.txt الساري وقت جلب الصفحة، ولا شيء بأثر رجعي.
curl -s https://example.com/robots.txt | grep -n -A3 -i "__usage_ai-training"
curl -sI https://example.com/robots.txt | grep -i -E "^(HTTP|content-type)"
ما الذي لا يفعله الرمز؟
- ليس بأثر رجعي: المحتوى الذي جُمع سابقًا غير مشمول، والتفضيل يسري على ما يُجلب أثناء وجوده.
- ليس معيارًا بعد: مسودة فردية تنتهي في 3 مايو 2027 ما لم تُحدَّث.
- ليس إلزامًا: الالتزام طوعي، والروبوتات التي تتجاهل robots.txt اليوم ستتجاهل هذا أيضًا.
- ليس دفعًا: تقول Microsoft إن التفضيلات «لا تنشئ ترتيبات ترخيص أو دفع».
- لا يشمل AI Overviews وAI Mode في بحث Google، فهي تتبع قواعد Googlebot وضوابط البحث المنفصلة.
كيف تساعدك آيفينيكس؟
تبني آيفينيكس مواقع وتطبيقات ومنتجات ذكاء اصطناعي ثنائية اللغة بالعربية والإنجليزية للشركات في الإمارات والسعودية ومصر، وتعمل على طريقة ظهورها في البحث بالذكاء الاصطناعي. لهذا التغيير نقدّم مراجعة قصيرة: نحدد أي مساراتك منتج وأيها أصل وأيها لا هذا ولا ذاك، ثم نكتب إعدادات robots.txt والصفحات لنظامك وشبكة التوزيع لديك، ونضبط فحصًا يتأكد أن الملف الحي يبقى صحيحًا بعد كل نشر. اطّلع على خدمات الذكاء الاصطناعي والبيانات.
الأسئلة الشائعة
كيف أمنع تدريب الذكاء الاصطناعي على موقعي عبر robots.txt؟
أضف مجموعة يكون سطر User-Agent فيها هو الرمز المشترك __usage_ai-training وبعده Disallow: / أو المسارات التي تريد حمايتها. أعلنت Google وMicrosoft وOpenAI وAnthropic في 30 أكتوبر 2026 أنها ستحترمه، لكن لا أحد يقرؤه بعد: Microsoft تبدأ في 1 فبراير 2027، وGoogle في مطلع 2027، وOpenAI «خلال الأشهر المقبلة»، وAnthropic تقول إنها بدأت التنفيذ. أبقِ قواعد GPTBot وGoogle-Extended وClaudeBot الحالية كما هي.
هل تؤثر إشارة __usage_ai-training على ترتيبي في Google أو Bing؟
لا، بحسب الشركتين. تقول Google إن Google-Extended، الذي تُترجم إليه الإشارة، لا يؤثر على الظهور في بحث Google ولا يُستخدم كإشارة ترتيب. وتقول Microsoft إن تفضيلات التدريب والتأريض لا تغيّر أهلية الظهور في نتائج Bing التقليدية. كما أن الإشارة ليست أمر زحف، فيستمر Googlebot وBingbot في اتباع قواعدك المعتادة.
هل يُخرج منع التدريب موقعي من إجابات Gemini وCopilot وChatGPT؟
يختلف حسب المزوّد. لدى Google ستُعامَل إشارة المنع، إن لم يوجد سطر صريح لـ Google-Extended، كحظر لـ Google-Extended الذي يشمل أيضًا الاستشهاد بالصفحات في Gemini Apps، فتفقد صفحاتك أهلية الظهور بروابط في إجابات Gemini. أما Microsoft ففصلت التدريب عن التأريض، والظهور في Copilot يُضبط بإعداد مستقل على مستوى الصفحة. وبحث ChatGPT يعتمد على OAI-SearchBot المنفصل عن التدريب. ولا تتأثر AI Overviews وAI Mode في بحث Google بهذه الإشارة.
ما الفرق بين Google-Extended وGPTBot وClaudeBot و__usage_ai-training؟
الثلاثة الأولى أسماء خاصة بشركة واحدة: Google-Extended رمز تحكم خاص بـ Google، وGPTBot وClaudeBot أسماء زواحف. أما __usage_ai-training فرمز محايد واحد تقرؤه كل شركة مشاركة كتفضيلك بشأن التدريب. وبحسب المسودة يمكن أن تتقدّم القاعدة الخاصة على العامة، فيبقى لمجموعة Google-Extended الصريحة الكلمة الأخيرة لدى Google.
هل تمنع المواقع الإخبارية والمتاجر العربية في الخليج ومصر تدريب الذكاء الاصطناعي؟
لا توجد إجابة واحدة، وهذه ليست استشارة قانونية. المواقع التي يكون المحتوى فيها هو المنتج، كالأخبار المدفوعة والأبحاث والدورات، لديها أقوى سبب للمنع. أما المتاجر ووثائق منصات SaaS وصفحات الخدمات الحكومية فتربح غالبًا من فهم المساعدات الذكية لها والاستشهاد بها، خصوصًا بالعربية حيث المحتوى الجيد أقل منه بالإنجليزية. والحل الوسط الشائع قاعدة على مستوى المسار: احمِ الأرشيف والمحتوى المدفوع، واسمح بصفحات المنتجات والوثائق والمواد الصحفية.
قراءات ذات صلة
- تحديث ووردبريس 7.1.4: قائمة التحديث لمواقع الخليج ومصر
- ثغرة PHP الحرجة php2shell: قائمة فحص لووردبريس ولارافيل
- جي بي تي 6.1 تيرا: السعر ودعم العربية وأتمتة الفواتير
- ووردبريس ثنائي اللغة دون انتظار
- بروتوكول Google UCP ودفع Shopify الأصلي: تجربة إلغاء الاشتراك
- ما هي آيفينيكس؟ تعريف الشركة وخدماتها
المصادر
- IETF، draft-kelley-aipref-training-preference-signal-00 (كيفن كيلي، 30 أكتوبر 2026) وصفحة الحالة
- كيفن كيلي، إعلان قائمة ai-control (30 أكتوبر 2026، 15:39 بالتوقيت العالمي)
- IETF AIPREF، مسودة المفردات -08 (13 سبتمبر 2026)
- مدونة Google Search Central، دعم ضابط مشترك لتدريب الذكاء الاصطناعي (30 أكتوبر 2026)؛ وثائق زواحف Google
- مدونة Microsoft Bing، محتواك واختيارك: تفضيلات أوضح للتدريب والتأريض (30 أكتوبر 2026)
- OpenAI، تسهيل تعبير المواقع عن تفضيلات تدريب الذكاء الاصطناعي (30 أكتوبر 2026)؛ زواحف OpenAI
- Cloudflare، وثائق إعداد robots.txt (محدّثة 22 أكتوبر 2026)؛ IETF، RFC 9309
- تغطية: PPC Land (31 أكتوبر 2026)، The Next Web
- صورة الغلاف: Victor Grigas / مؤسسة ويكيميديا، ويكيميديا كومنز، رخصة CC BY-SA 3.0، مقصوصة. الصورة داخل المقال: Tony Webster، ويكيميديا كومنز.jpg)، رخصة CC BY 2.0، مقصوصة.
